上下文压缩与用量查看
查看当前上下文与实际用量,必要时压缩长对话,保留继续工作的关键信息。
理解用量数字
当前会话的上下文占用描述下一次模型请求需要携带多少信息;输入、输出和缓存 token 记录描述已经发生的请求用量。两者不是同一个统计。长工具输出、图片和附加指令也可能增加上下文开销。
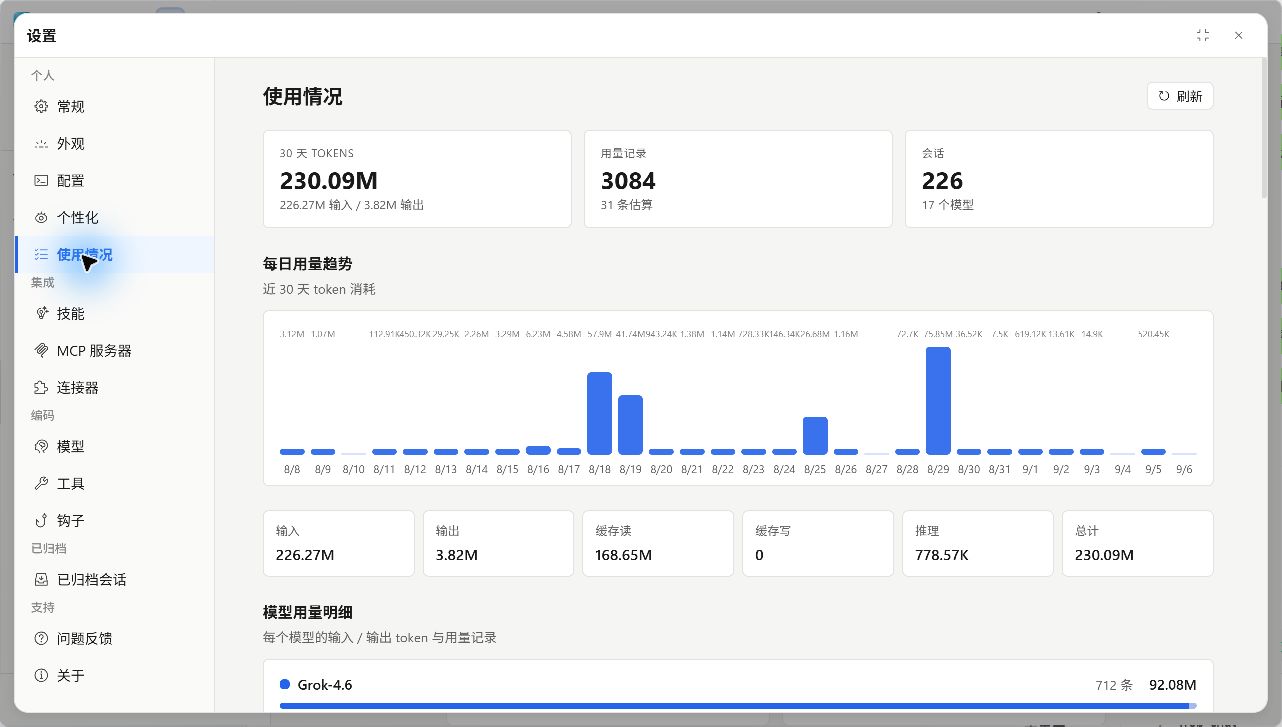
TUI 使用 /tokens 查看会话用量。桌面端在模型与状态区域查看当前信息,在设置 > 使用情况查看汇总、记录和会话统计。不同服务商上报的字段可能不同,缺失的统计不应当作零消耗。
手动与自动压缩
输入并提交 /compact 可主动压缩已有上下文。压缩需要模型生成接续摘要,因此仍会发起模型请求。界面会展示压缩过程,成功后收起为 Context compacted 一类完成记录,可以展开查看。
当前自动压缩在活动上下文达到模型标称窗口的 90% 时触发。窗口值来自当前模型配置,因此应该按服务商的实际限制设置,不能靠随意增大窗口数字解决服务端超限。
压缩保留继续工作需要的摘要和最近用户信息,人类可见的聊天记录不会因此被截短。恢复会话时会继续使用有效压缩记录后的上下文。如果压缩失败,阅读错误原因再处理,不要把失败的压缩当作已经完成。
让后续请求更清楚
- 引用明确的文件和范围,避免反复粘贴整个大型日志。
- 保留目标、已经验证的结论、未完成事项和重要约束。
- 任务主题已经改变时,考虑新建任务并附上必要交接信息。
- 超限时先确认实际模型窗口、输出限制与错误内容,再压缩或拆分输入。
压缩减少后续上下文负担,不会退回已经消耗的 token。连接中断或服务端限制导致的错误,按上下文超限与请求失败继续排查。